Proyecto de Tesis: Kuro Custom
Diseño, implementación y validación de una infraestructura cloud de alta disponibilidad y escalabilidad elástica en Linux (Ubuntu Server 24.04 LTS en AWS us-east-1) mediante Kubernetes autogestionado (kubeadm), segmentación de red con Calico CNI, observabilidad e Ingeniería del Caos, validada con pruebas de estrés independientes de 30,000 peticiones HTTP concurrentes (300 hilos en Apache JMeter).
Infraestructura cloud aprovisionada con herramientas declarativas (Terraform, Ansible, manifiestos de Kubernetes), sin credenciales en texto plano en el repositorio y con el ciclo de vida automatizado mediante GitHub Actions.
Riesgos de Redes Planas & Despliegues Frágiles
El despliegue tradicional de plataformas e-commerce suele sufrir "configuration drift", periodos de inactividad costosos durante los despliegues, sobrecostos de nube descontrolados y vulnerabilidades en redes internas planas. Además, muchas organizaciones adoptan servicios cloud administrados sin evaluar alternativas, o configuran clústeres sin un control granular del tráfico interno. La pregunta de investigación fue cómo una arquitectura cloud automatizada (IaC y orquestación de contenedores sobre Linux) mitiga la desviación de configuración, reduce los tiempos de despliegue y asegura la alta disponibilidad frente al aprovisionamiento manual. El objetivo central fue diseñar e implementar una arquitectura cloud integral, escalable y tolerante a fallos, basada en Linux y tecnologías nativas de la nube, y validarla empíricamente sobre Kuro Custom, una plataforma de comercio electrónico (backend en Django, frontend en Astro/React y PostgreSQL 16.3). La fase experimental se acotó exclusivamente a AWS (sin GCP, Azure, EKS ni autoescalado de VMs) con Ubuntu Server 24.04 LTS (seleccionada tras contrastar distribuciones Linux empresariales), Kubernetes autogestionado (kubeadm), Calico CNI, observabilidad y automatización declarativa (Terraform + Ansible + GitOps), soportando picos de hasta 800% de CPU sobre la cuota base con disponibilidad continua, bajo principios de FinOps y Green Cloud Computing.
Frontend → Backend API
ALLOWEDPermitido exclusivamente mediante NodePort 30800 y abstracción del Service de K8s.
Worker Nodes → Private RDS :5432
INTERNALEnrutamiento VPC interno sin costo de NAT Gateway; egress bloqueado.
Flujos Denegados Implícitamente
DENIEDEl frontend no puede conectar directo a RDS (5432); el namespace de monitoreo está aislado.
Protocolos de Caos & Saturación
Resultados medidos con Apache JMeter en dos corridas independientes (300 hilos con rampa de 60 s y 100 iteraciones cada uno: 30,000 peticiones HTTP por corrida): una sobre el frontend y otra sobre la API del backend, con picos del HPA de hasta 794% y 800% de CPU.
Calico v3.28 · default-deny-ingress · Pod CIDR: 192.168.0.0/16
Infraestructura Declarativa y Segmentación de Red
Despliegue sobre Amazon Web Services (AWS) en us-east-1 siguiendo la metodología Twelve-Factor App y los pilares del AWS Well-Architected Framework:
Infraestructura como Código y Red (IaC)
VPC (10.0.0.0/16) declarativa dividida en subnets públicas y privadas en us-east-1a y us-east-1b. Application Load Balancer Multi-AZ con enrutamiento por rutas (/api/* a Django, / a Astro/React) y TLS mediante ACM, con DNS gestionado en Cloudflare.
Capa de Nodos, Hardening y Runtime containerd
Aprovisionamiento con Ansible en 4 capas: hardening del SO (SSH, sysctl, swap deshabilitado), herramientas de contenedores (containerd, kubeadm), inicialización del clúster con Calico y Metrics Server, y observabilidad. Un plano de control (c7i-flex.large) y 2 workers (m7i-flex.large) en ambas zonas.
Capa de Datos Aislada sin Costo de NAT Gateway
Base de datos en subnets privadas sin Internet Gateway ni NAT costoso; el enrutamiento VPC interno permite acceso seguro exclusivamente desde el Security Group de workers en el puerto 5432, sin acceso público, con cifrado en reposo (KMS) y con egress bloqueado.
Segmentación de Red con Calico CNI
Modelo default-deny-ingress con listas de permitidos explícitas por servicio y reglas de egress específicas para backend y frontend, que impiden el tráfico no autorizado entre pods y el movimiento lateral. El namespace de monitoreo tiene su propia política default-deny-ingress y reglas de permitidos explícitas.
Observabilidad Inmutable & Telemetría Continua
Stack aprovisionado automáticamente mediante ConfigMaps y Secrets (sin contraseñas en git), con Prometheus recolectando métricas de Node Exporter y cAdvisor para medir la saturación de nodos y pods durante las pruebas.
Contenedores y CI/CD GitOps
Imágenes de backend (Django) y frontend (Astro/React) publicadas en Docker Hub. Pipelines separados de infraestructura (Terraform + Ansible) y aplicación, SSH efímero cerrado con if: always() y un workflow de seguridad (Tfsec en modo advertencia y Trivy, que falla ante CVEs CRITICAL).
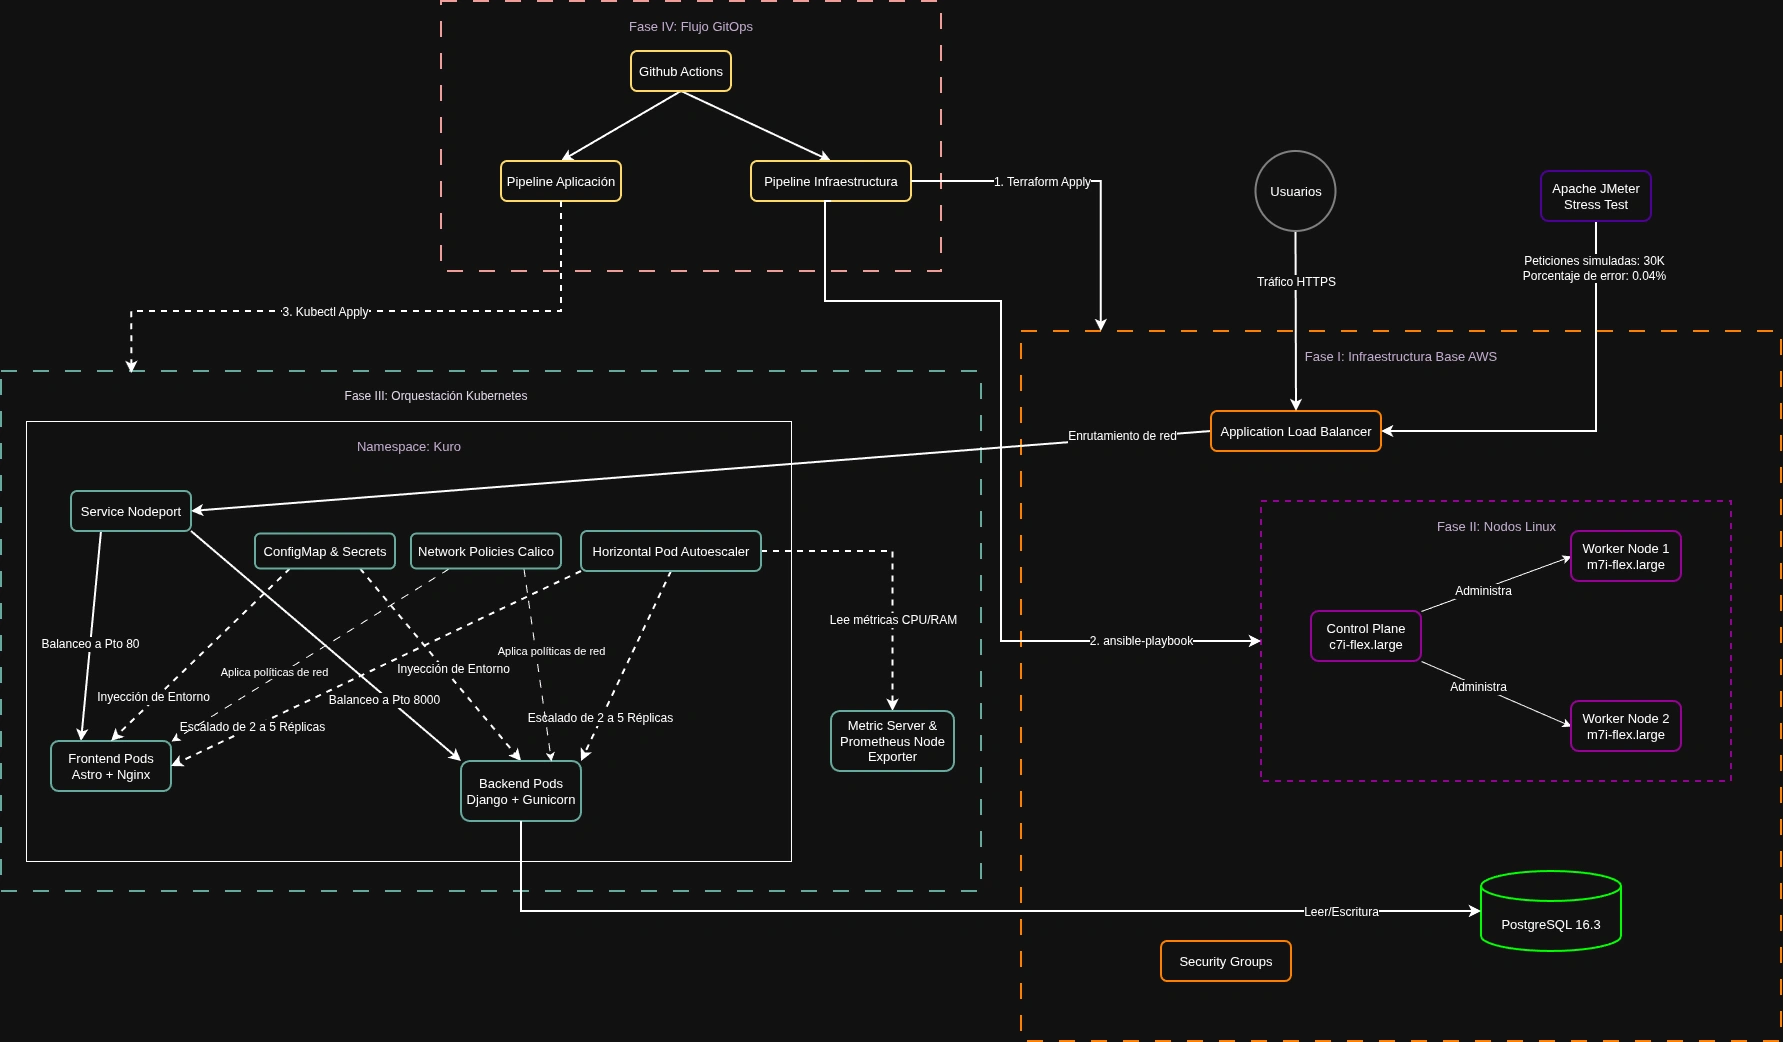
Arquitectura Global de la Tesis (AWS Multi-AZ & K8s)
Vista integral en cuatro fases: (I) infraestructura base en AWS con ALB, Security Groups y RDS PostgreSQL 16.3; (II) nodos Linux (1 control plane y 2 workers); (III) orquestación en Kubernetes con los pods de frontend (Astro SSR sobre Node) y backend (Django + Gunicorn), HPA, Network Policies de Calico, Metrics Server y Node Exporter; (IV) flujo GitOps con GitHub Actions. Incluye la prueba de estrés con JMeter contra el ALB.
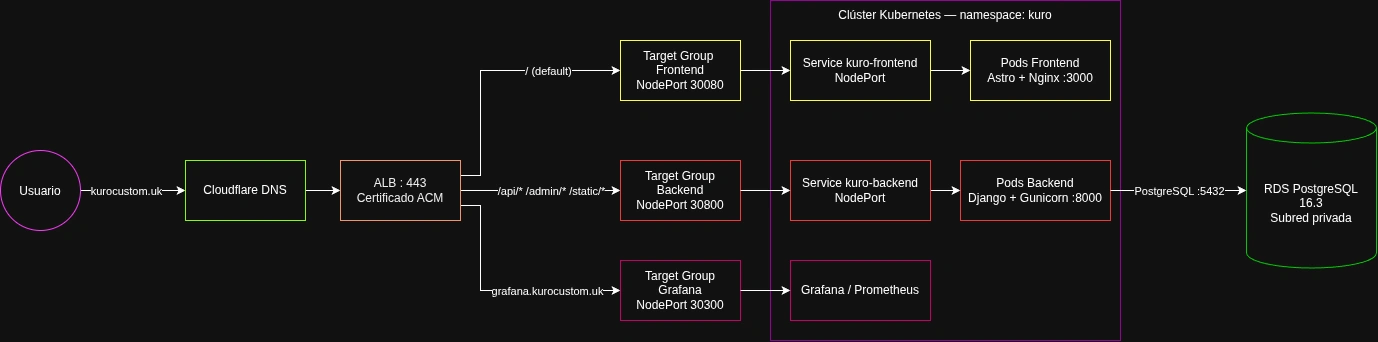
Flujo de Petición del Usuario y Enrutamiento ALB
El usuario resuelve kurocustom.uk vía Cloudflare DNS y llega al ALB (443, certificado ACM). Por defecto (/) va al frontend (NodePort 30080); /api/*, /admin/* y /static/* van al backend Django (NodePort 30800); y el host grafana.kurocustom.uk va a Grafana (NodePort 30300). El backend es el único que se conecta a RDS por el puerto 5432.
Hallazgos Empíricos & Producción
La validación experimental mostró 0.00% de errores en el frontend y 99.98% de éxito en la API del backend (0.02% de error) bajo carga extrema, sobre una infraestructura de nodos fijos.
- >Frontend bajo estrés: 30,000 peticiones con 374.87 req/s, 301.79 ms de tiempo promedio y 0.00% de errores. API backend: 195.00 req/s y 99.98% de éxito (0.02% de error).
- >Escalado elástico validado: el HPA pasó de 2 a 5 réplicas con picos de 794% (frontend) y 800% (backend) de CPU, y volvió a 2 réplicas tras el enfriamiento.
- >Alta disponibilidad Multi-AZ: ante la caída abrupta de un Worker Node, el ALB convergió en menos de 60 s y el servicio nunca sufrió una caída total.
- >MTTR reducido de horas a minutos: reconstrucción automatizada de un nodo destruido en 3 min 44 s mediante GitHub Actions, Terraform y Ansible.
- >Desacoplamiento de la persistencia: Amazon RDS absorbió 25 conexiones simultáneas con un pico de solo 18.1% de CPU. Segmentación interna con Calico CNI.
- >Auditoría de inmutabilidad: terraform plan detectó y revirtió el Configuration Drift manual en un Security Group. Alineación con Twelve-Factor App, FinOps y Green Cloud Computing.
Compromisos de Diseño & Justificación
Cada elección técnica documenta sus razones conscientes, costos asociados y la profundidad académica alcanzada.
Kubernetes autogestionado (kubeadm) en lugar de Amazon EKS
Se eligió kubeadm sobre EC2 para evitar el costo fijo de $0.10/hora (~$73/mes) del control plane de EKS, que queda fuera del AWS Free Tier, y para observar directamente en Prometheus etcd, kube-apiserver y scheduler, sin la abstracción de un servicio gestionado. Como compromiso, no hay Cluster Autoscaler nativo: el HPA escala pods, pero los nodos son fijos.
Nodos EC2 de capacidad fija como decisión metodológica
Los 3 nodos (1 control plane c7i-flex.large y 2 workers m7i-flex.large, en distintas Zonas de Disponibilidad) se aprovisionaron con capacidad fija por diseño experimental, para que las pruebas de Ingeniería del Caos fueran reproducibles y comparables entre ejecuciones. Es una decisión deliberada, distinta del antipatrón de static sizing; en producción se usarían Auto Scaling Groups o EKS con Karpenter.
Calico CNI con segmentación de red estricta (Network Policies)
A diferencia de Flannel (solo conectividad VXLAN sin segmentación), Calico programa reglas iptables que aplican un modelo default-deny-ingress: el frontend no puede acceder directamente a RDS, el backend no inicia conexiones hacia el frontend y el namespace de monitoreo queda aislado. Complementan la política una serie de reglas de egress específicas para backend y frontend.
Base de datos RDS en subnets privadas sin costo de NAT Gateway
RDS solo atiende conexiones entrantes de los workers y nunca inicia conexiones hacia internet. Al estar en la misma VPC, los workers acceden a PostgreSQL por enrutamiento interno, sin necesidad de un NAT Gateway y su costo asociado. En la prueba de estrés, la base absorbió 25 conexiones simultáneas con un pico de apenas 18.1% de CPU.
Horizontal Pod Autoscaler (HPA) con Target Tracking al 50%
Elasticidad automática dentro del clúster: los Deployments de backend y frontend escalan de 2 a 5 réplicas cuando el uso promedio de CPU supera el 50%. Con 30,000 peticiones por prueba (300 hilos), el frontend registró 0.00% de errores y el backend 0.02% (5 respuestas HTTP 502 antes de que las nuevas réplicas superaran sus readiness probes); tras ~10 minutos de enfriamiento volvieron a 2 réplicas.
CI/CD dinámico y DevSecOps con apertura efímera de puertos
El pipeline de GitHub Actions abre el puerto SSH (22) en los Security Groups solo para la IP del runner durante la ejecución del job, y lo cierra con if: always() aunque el pipeline falle. Un workflow de seguridad independiente ejecuta Tfsec sobre Terraform (soft_fail) y Trivy sobre las imágenes, y falla ante vulnerabilidades CRITICAL. El mismo pipeline reconstruyó un nodo terminado en 3 min 44 s.
Frontend Astro/React servido dentro del clúster Kubernetes
Se evaluó y descartó S3 + CloudFront para mantener el tráfico de la UI dentro del clúster bajo estudio. Servir el frontend en Kubernetes permitió medir el impacto de la carga completa (frontend y backend) en el HPA y en las métricas de Prometheus, sin variables externas como el caché de una CDN.
Gestión DNS y certificados TLS automatizados (Terraform + Cloudflare)
Integración del proveedor de Cloudflare en Terraform para resolver los cambios de DNS al recrear la infraestructura: crea los registros de validación de ACM y actualiza los CNAME del dominio principal (www y @) y de Grafana para que apunten al nuevo ALB.
Kubernetes autogestionado (kubeadm) en lugar de Amazon EKS
Se eligió kubeadm sobre EC2 para evitar el costo fijo de $0.10/hora (~$73/mes) del control plane de EKS, que queda fuera del AWS Free Tier, y para observar directamente en Prometheus etcd, kube-apiserver y scheduler, sin la abstracción de un servicio gestionado. Como compromiso, no hay Cluster Autoscaler nativo: el HPA escala pods, pero los nodos son fijos.
Nodos EC2 de capacidad fija como decisión metodológica
Los 3 nodos (1 control plane c7i-flex.large y 2 workers m7i-flex.large, en distintas Zonas de Disponibilidad) se aprovisionaron con capacidad fija por diseño experimental, para que las pruebas de Ingeniería del Caos fueran reproducibles y comparables entre ejecuciones. Es una decisión deliberada, distinta del antipatrón de static sizing; en producción se usarían Auto Scaling Groups o EKS con Karpenter.
Conclusiones
La investigación demostró empíricamente la viabilidad técnica, económica y operativa de sustituir la administración manual de servidores por una arquitectura Cloud-Native gobernada con IaC, orquestación de contenedores y CI/CD. Sobre el caso Kuro Custom se valida la hipótesis: la codificación declarativa de la infraestructura junto con Kubernetes reduce los tiempos de despliegue y recuperación, erradica las interrupciones por errores humanos de configuración y optimiza el consumo de cómputo.
01Sistema operativo base: Ubuntu Server 24.04 LTS
Con kernel Linux 6.8.0-1008-aws y runtime containerd, sin interfaz gráfica, el nodo mantuvo una huella ligera: 14.8% de RAM sobre 8 GiB durante las pruebas de máxima exigencia, dejando casi todo el hardware a los microservicios.
02Idempotencia y fin del Configuration Drift (Terraform)
Los módulos de Terraform aprovisionaron VPC, ALB, instancias EC2 y Amazon RDS (PostgreSQL). En la auditoría sobre el Security Group sg_kuro_custom, terraform plan detectó la alteración manual y la revirtió en sitio (1 to change, 0 to destroy).
03Automatización, hardening y DevSecOps (Ansible y GitHub Actions)
Con inventario dinámico en AWS, SSH efímero solo durante el runner y configuración desatendida de containerd, un nodo destruido se reconstruyó e integró desde cero en 3 min 44 s.
04Alta disponibilidad Multi-AZ, self-healing y elasticidad (Kubernetes y Calico)
Clúster Kubernetes v1.29.15 (kubeadm). Pods eliminados se recuperaron en 7 a 42 s sin caída; ante la detención de un worker, el ALB lo aisló en menos de 60 s y Kubernetes reprogramó las réplicas (HTTP 200 continuo); con picos de CPU de 794% (frontend) y 800% (backend), el HPA escaló ambos servicios de 2 a 5 réplicas repartidas entre los nodos.
05Observabilidad, rendimiento bajo estrés, FinOps y Green Cloud
Con 30,000 peticiones concurrentes (300 hilos en JMeter): frontend con 374.87 req/s, 301.79 ms promedio y 0.00% de errores; API con 195.00 req/s y 99.98% de éxito (5 errores 502, 0.02%); RDS con máximo de 18.1% de CPU y 25 conexiones. El scale down a 2 réplicas llevó la CPU a 1%-2%, evitando el sobreaprovisionamiento estático (FinOps) y los recursos ociosos (Green Cloud).
Siguientes pasos para Kuro Custom
Líneas de desarrollo derivadas de las delimitaciones operativas y presupuestales de la investigación (sección 1.7.2) y de la evolución del ecosistema Cloud-Native.
Plano de control gestionado (Amazon EKS)
Migrar de kubeadm sobre EC2 a EKS, delegando al proveedor la alta disponibilidad, el escalado y el parchado del API Server y de etcd.
Autoescalado de nodos (Karpenter / Cluster Autoscaler)
Hoy el HPA escala pods sobre una flota fija de EC2; se propone aprovisionar y destruir nodos de forma autónoma cuando los pods agoten la capacidad física.
Malla de servicios (Istio o Linkerd)
Zero-Trust con mTLS transparente en el tráfico este-oeste, además de Canary Releases y pruebas A/B sin modificar el código.
Trazabilidad distribuida (OpenTelemetry)
Instrumentar los microservicios con OpenTelemetry y Jaeger o Grafana Tempo para trazar cada transacción desde el ALB, pasando por Django, hasta la consulta SQL en RDS.
Topología Multi-Región Activo-Activo
Extender Terraform a varias regiones de AWS con enrutamiento por latencia en Amazon Route 53 y réplicas de lectura interregionales en RDS.